1. 速览:一页读懂 ZGCM-1
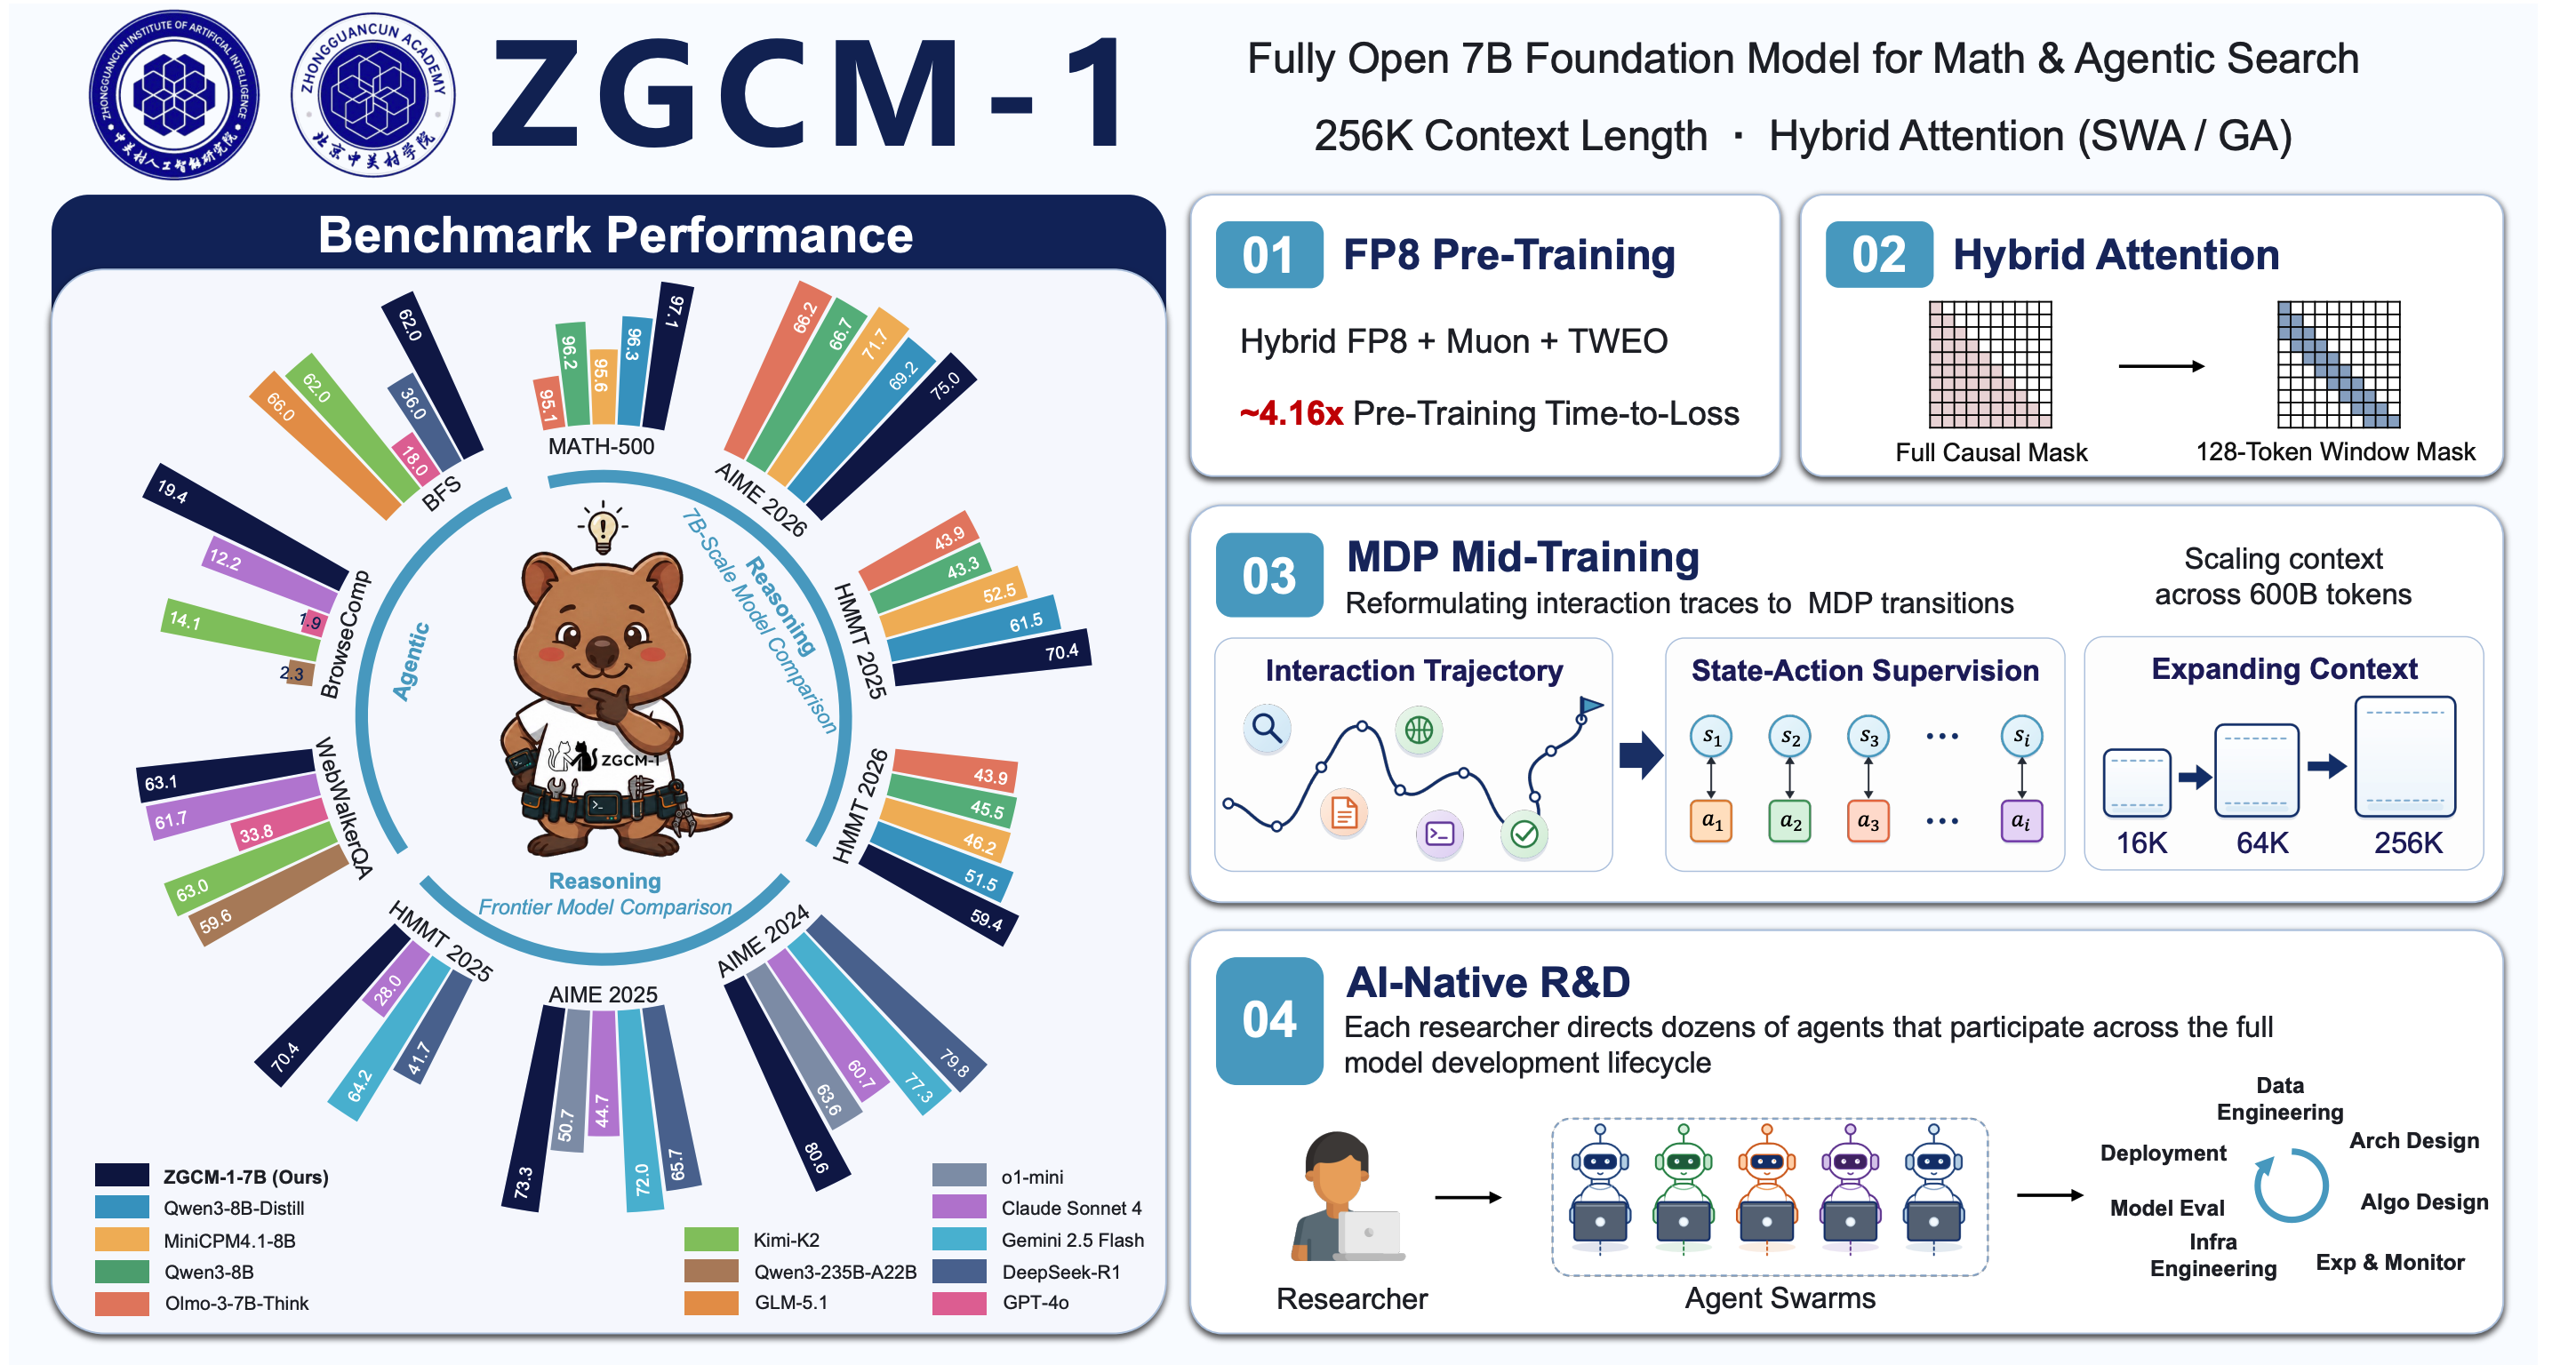
一句话总结:在“前沿推理只属于千亿参数模型”的行业叙事之外,ZGCM-1 用一套完全公开的训练配方,把 7.39B 的 dense 模型做到数学推理与 Agentic 搜索上可与体量大两个数量级的前沿模型掰手腕——方法是让“内部深思(deliberate thinking)”与“外部主动检索(active external tool use)”互补,而不是靠参数记忆整个开放网络。
1.1 四大技术支柱
1.2 关键成绩
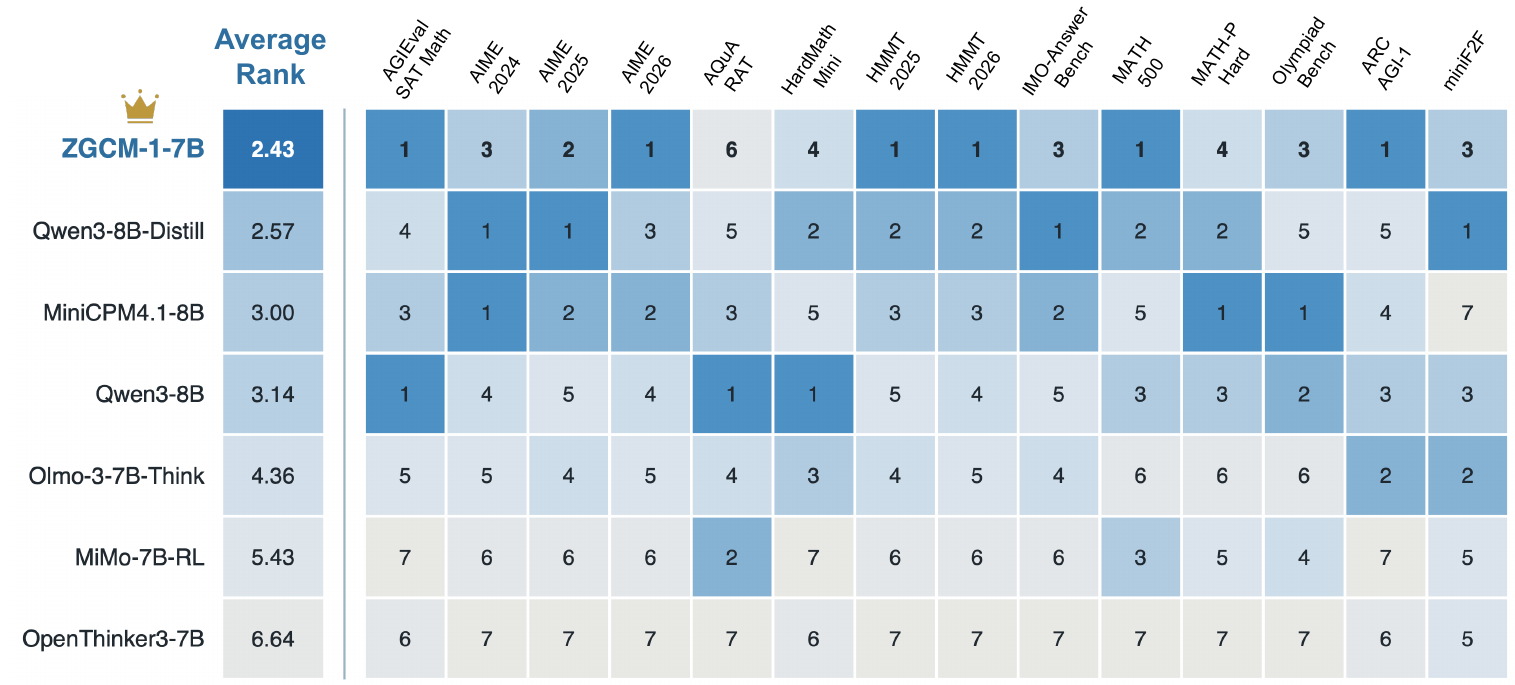
- 数学与推理:MATH-500 97.13%、AIME 2026 75.00%、HMMT 2025 70.42%;在报告对比的 7B–8B 模型中,14 项推理基准的平均排名第一。
- Agentic:WebWalkerQA 63.09%、BrowseComp 19.43%、GAIA(text-only) 42.52%、Binary Function Search 62.00%。
- 开放性:开源预训练 / 中训练 / 后训练各阶段权重与中间 checkpoint、训练代码与配置、分阶段数据与数据配方、W&B 日志、评测 harness。
2. 背景与核心论点
报告开篇指出:尽管基础模型在长程推理与工具增强的 Agent 能力上推进迅猛,但学术社区被两堵墙挡在外面——
| 壁垒 | 含义 |
|---|---|
| 规模壁垒 The Scale Barrier |
前沿推理与深度 Agentic 搜索被视为“千亿参数系统的专属领地”,令算力受限的研究者无法参与训练与探索前沿智能。 |
| 不透明壁垒 The Opacity Barrier |
多数有竞争力的模型只开放权重(open-weight)而非完全开源;上游过滤配方、中训练课程、长上下文调度、多轮 Agent 轨迹全部是黑箱,无法系统研究训练动力学与容量上限。 |
ZGCM-1 的应对方式:一个从零训练、透明开源的 7.39B dense 基础模型。它不追求“用参数记住开放网络”,而是把能力建立在两种机制的耦合上:
- 内部深思:长程链式思维(long-horizon CoT)推理;
- 外部主动搜寻:自主工具使用——主动搜集网页证据、操作系统终端、分析被 strip 的二进制程序。
3. 模型架构:混合注意力骨干
3.1 规格
| 项目 | 取值 |
|---|---|
| 架构 | Decoder-only dense Transformer + GQA |
| 参数规模 | 约 7.39B |
| 层数 / 隐层维度 | 32 层 / 4,096 |
| SwiGLU 中间维度 | 11,008 |
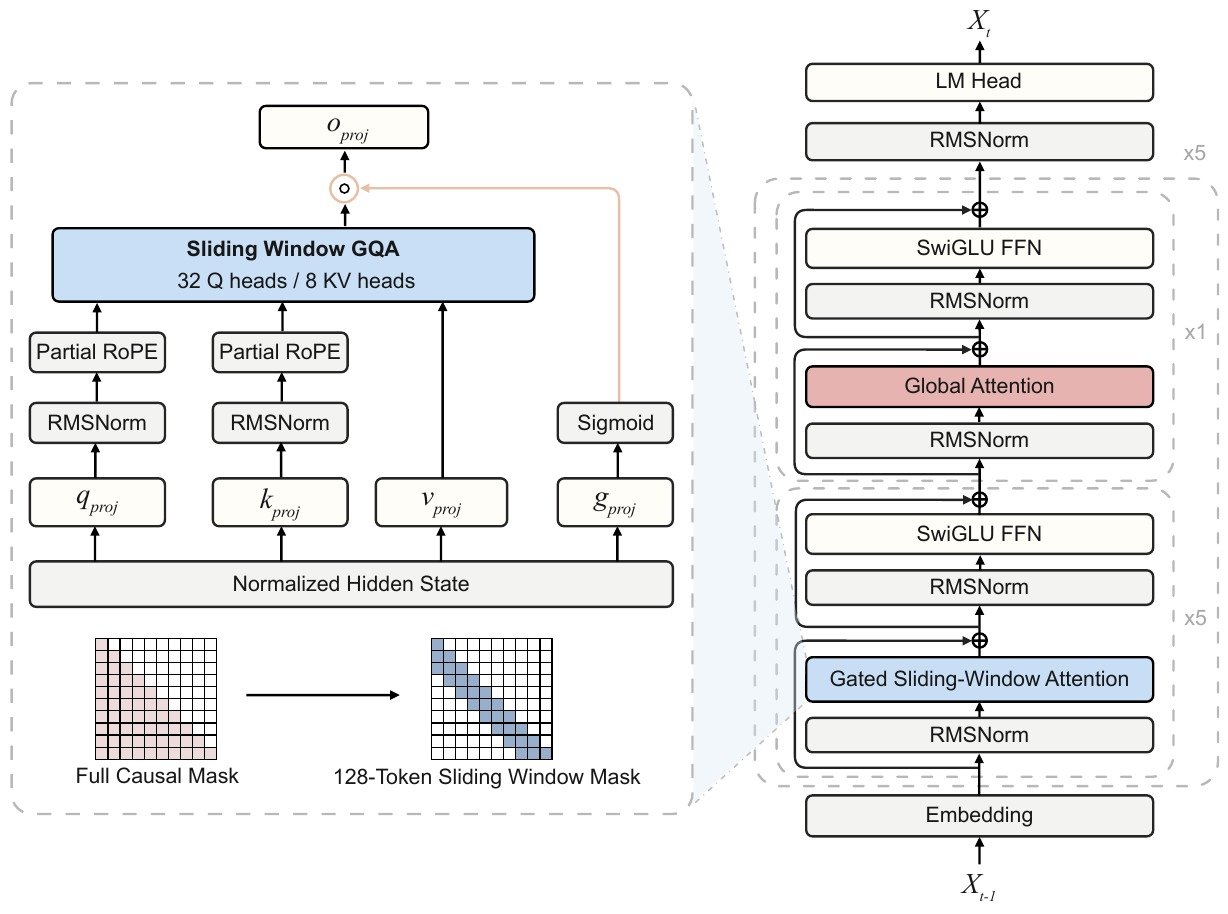
| 注意力头 | 32 query heads / 8 KV heads(head dim 128) |
| 注意力排布 | 27 层门控滑窗注意力(窗口 128 tokens)+ 5 层全局注意力(5:1) |
| 全局层位置 | 第 6、12、18、24、30 层(1 起计);即“5 局部 + 1 全局”重复 5 次,再跟 2 个尾部局部层 |
| 归一化 / 位置编码 | RMSNorm;QK 归一化(用 RMSNorm 实现);Partial RoPE(旋转比例 0.33) |
| 激活函数 | SwiGLU |
| 最大上下文 | 262,144 tokens(256K) |
3.2 门控滑窗注意力(Gated SWA)
对归一化后的隐状态 h,门控 SWA 模块并行生成 query / key / value / gate 四路投影;query 与 key 分支施加 RMS 归一化与 Partial RoPE。设 A_SWA(q,k,v) 为 128-token 滑窗 GQA 输出,则:
GatedSWA(h) = oproj( A_SWA(q, k, v) ⊙ σ( gproj(h) ) )其中 σ 为 sigmoid,学习到的门控对局部注意力输出做逐元素调制后再送入输出投影。全局注意力层不加门控,直接在完整上下文上做注意,负责跨窗口的信息流动。
4. 架构实验与 KV Cache 分析
4.1 注意力方案的选型实验
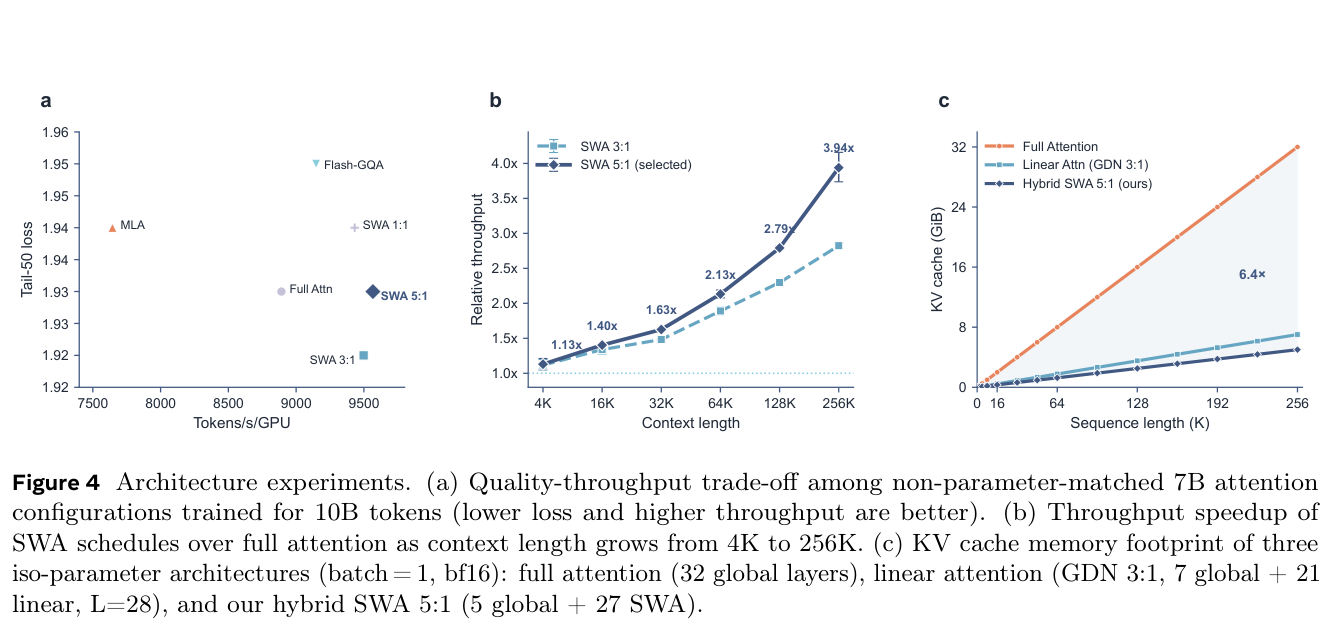
为选出生产用注意力方案,作者对比了全注意力、Flash-GQA、MLA,以及 SWA 1:1 / 3:1 / 5:1 三种滑窗比例。所有配置均在 8×H100 上以相同预算训练 10B tokens、序列长度 4,096。质量指标为最后 50 步的平均 loss,效率指标为 tokens/s/GPU。
| 配置 | 吞吐 (tokens/s/GPU) | Tail-50 loss | 结论 |
|---|---|---|---|
| Full Attention | ≈8,900 | 1.93 | 基线 |
| Flash-GQA | ≈9,000 | 1.955 | — |
| SWA 1:1 | ≈9,100 | 1.945 | — |
| SWA 3:1 | ≈9,300 | 1.92 | loss 最低 |
| SWA 5:1(选中) | 9,566 | 1.93 | 吞吐最高,loss 与全注意力持平 |
| MLA | 7,645 | 1.94 | 吞吐代价大,无对应 loss 收益 |
注:表中 Full/Flash-GQA/SWA 1:1/3:1 的吞吐数值由原文 Figure 4a 的散点位置近似读取,仅 SWA 5:1 = 9,566 与 MLA = 7,645 为原文明确给出的数值。
随着上下文从 4K 增长到 256K,SWA 5:1 相对全注意力的吞吐优势持续扩大:4K 时 1.13× → 16K 1.40× → 32K 1.63× → 64K 2.13× → 128K 2.79× → 256K 3.94×;SWA 3:1 位于两者之间。这一“差值随上下文拉大”的特性,使门控 SWA 特别适合长上下文训练与推理——因为此时全注意力成为主导性的计算瓶颈。
4.2 KV Cache 分析
由于 27 个 SWA 层在 KV Cache 中只保留固定的 128-token 窗口,而仅 5 个全局层存储完整序列,每 token 的 KV 占用从 128 KiB(全注意力)降到 20 KiB。在 256K 上下文、batch=1、bf16 下:
| 架构 | 层构成 | 参数量 | 256K KV Cache |
|---|---|---|---|
| Full Attention | 32 全局层 | 7.39B | 32.0 GiB |
| Linear Attn (GDN 3:1) | 7 全局 + 21 线性(L=28) | 7.47B | 7.0 GiB |
| Hybrid SWA 5:1(本文) | 5 全局 + 27 SWA | 7.39B | 5.0 GiB(↓6.4×) |
作者强调:自回归解码是内存带宽受限的,因此更小的 KV 占用可直接转化为更高的解码吞吐——这正是长推理与 Agentic 搜索这类“天然长上下文”负载最需要的特性。
5. 预训练:数据处理、课程与效率配方
预训练分两段:通用预训练(General Pre-Training,2 个数据阶段) + 中训练(Mid-Training,3 个上下文阶段)。通用预训练建立语言、知识、数学、代码的广谱能力;中训练保持全序列因果语言建模目标,但引入更稠密的推理/指令/Agentic 数据,并把上下文逐步拉长到 256K。
5.1 数据混合
先用一个 0.3B 参数代理模型在约 30B tokens 上搜索数据配比(通过知识、代码、数学的训练 loss 与评测信号迭代调整),以较低成本替代目标规模上的配比探索。最终语料来源包括:
- Web:精选英文网页语料为主,配合受控比例的中文网页数据;保留上游文档级质量分与质量分层。
- 学术与 OCR:教育过滤后的 PDF 视图 + Ai2 的 OCR 科学内容(olmOCR 管线);arXiv 科学论文由内部管线抽取清洗。
- 代码:代码密集型网页 + 开源仓库文件(转换为文本视图、规范化文件级元数据)。
- 数学:数学语料的高质量 tier + 分类器过滤的网页数学 + 教材(沿用 SmolLM2 的数学数据配方);处理时保留 LaTeX 公式及其周围推理上下文(类似 Proof-Pile-2)。
- LaTeX 论文:RedPajama-1T 的 arXiv LaTeX 源切片 + 过滤后的近期 TeX 源。
- 专用推理数据:Nemotron-Pretraining-Specialized-v1 的高质量推理视图,作为 Stage 2 中独立受控的混合分量(不并入通用网页/数学池)。
所有文档统一 schema、按版本化 shard 落盘并登记 manifest,用 GLM-5.1 tokenizer 分词与索引;跨阶段去重确保 Stage-1 内容不会再次进入 Stage-2 采样。
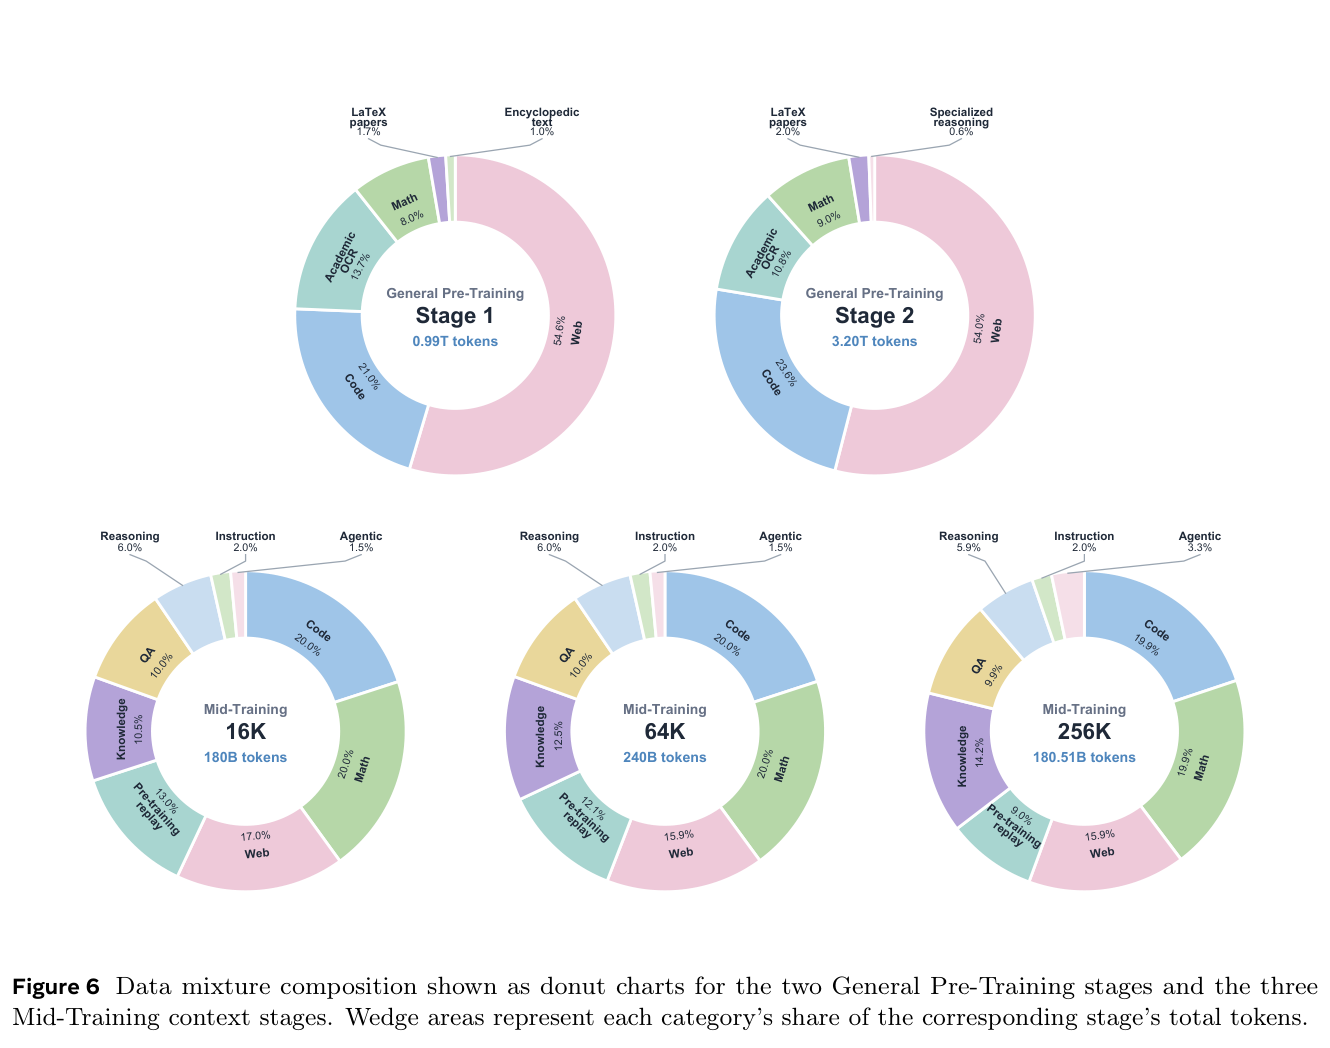
| 来源 | Stage 1 | Stage 2 | 变化 |
|---|---|---|---|
| Web | 54.6% | 54.0% | 两阶段最大来源,基本持平 |
| Code | 21.0% | 23.6% | ↑ 提升代码占比 |
| Academic OCR | 13.7% | 10.8% | ↓ |
| Math | 8.0% | 9.0% | ↑ |
| LaTeX papers | 1.7% | 2.0% | ↑ |
| Encyclopedic text | 1.0% | — | Stage 2 移除 |
| Specialized reasoning | — | 0.6% | Stage 2 新增 |
5.2 课程式预训练(Curriculum Pretraining)
用 Stage 1 的 0.99T 作为课程阶段:通用语言文档按词法复杂度从低到高呈现,代码与数学则各自独立交织。7B 探针实验结果显示,该调度使 coding BPB 从 1.99 降到 0.81、mathematics BPB 从 0.97 降到 0.94,而通用基准 BPB 上升 0.03–0.09。课程只作用于 Stage 1;后续阶段在完整混合上训练,不做复杂度排序。
词法复杂度对通用语言文本是廉价且可扩展到语料级的排序信号,但对代码与数学是糟糕的难度代理——表层统计反映的是样板代码/模板化表述,而非算法或推理深度。
因此只对“非代码、非数学”数据排序,并独立交织代码与数学;同时剔除极端高复杂度的离群文档(通常是损坏/乱码文本)。该调度在技术域上改善 BPB,代价是通用域拟合损失 0.03–0.09 BPB。
5.3 超参与数值精度
| 维度 | 配置 |
|---|---|
| 训练框架 / 硬件 | NVIDIA Megatron Core,H100 GPU |
| 矩阵参数优化器 | Muon:momentum 0.9,spectral scaling,5 步 Newton–Schulz,常数学习率 2×10⁻⁴,weight decay 0.1,梯度裁剪 1.0 |
| 标量参数优化器 | Adam |
| 数值精度 | 矩阵乘用 Transformer Engine hybrid FP8(前向 E4M3 / 反向 E5M2)delayed scaling,缩放因子取自 1,024 步历史的最大绝对值;其余算子保持 BF16 / FP32 |
| 离群值正则 | TWEO 作为激活正则项,抑制极端中间值,与 delayed scaling 互补 |
| 效率 | 16K 生产运行约 585 model TFLOP/s/GPU,即约 60% BF16 等效 MFU(H100 BF16 dense 峰值 989 TFLOP/s) |
抑制中间激活的离群值对 FP8 训练稳定性至关重要;delayed scaling 结合 TWEO 正则,能在规模上防止数值发散的同时维持 60% BF16 等效 MFU。
5.4 ≈4.2× 效率增益的构成
作者以“OLMo 3 风格的 7B BF16/AdamW 基线”为参照估算 16K 预训练的 time-to-loss,四个因子相乘:
其中 Muon 的 1.8× 是step-to-loss 效率(相对 AdamW),Pre-LN 的 1.1× 来自探索性 7B 证据的数据效率。
混合 SWA(1.4×)、FP8 混合精度系统(1.5×)、Muon 优化器(1.8×)与 Pre-LN(1.1×)的协同设计,相对标准 BF16/AdamW 基线在 16K 预训练 time-to-loss 上累计带来约 4.2× 加速。
6. 中训练:600B tokens 与 MDP 状态-动作监督
中训练是以能力为导向的持续预训练。作者先做池级去重以提升 token 效率、控制重复内容,得到约 2.86T tokens 的候选池,再采样出 600.51B tokens 的调度,组织为 16K / 64K / 256K 三个上下文阶段。
6.1 顶层能力混合
| 类别 | 16K(180B) | 64K(240B) | 256K(180.51B) | 趋势 |
|---|---|---|---|---|
| Code | 20.0% | 20.0% | 19.9% | 全程≈20%,保持编程能力 |
| Math | 20.0% | 20.0% | 19.9% | 全程≈20%,保持推理能力 |
| Web | 17.0% | 15.9% | 15.9% | 略降 |
| Knowledge | 10.5% | 12.5% | 14.2% | ↑ 提升长文档密度 |
| QA | 10.0% | 10.0% | 9.9% | 稳定 |
| Reasoning | 6.0% | 6.0% | 5.9% | 稳定 |
| Instruction | 2.0% | 2.0% | 2.0% | 稳定 |
| Agentic | 1.5% | 1.5% | 3.3% | ↑ 提升工具交互/多步任务密度 |
| Pretraining replay | 13.0% | 12.1% | 9.0% | ↓ 但仍保留,维持广谱覆盖 |
关键设计:各阶段累加而非替换更短序列——64K 阶段 = 180.89B(≤16K)+ 59.11B(16K–64K);256K 阶段 = 127.81B(≤16K)+ 21.72B(16K–64K)+ 30.98B(>64K)。这样在拉长上下文的同时持续 replay 短上下文数据,避免常规上下文任务的能力退化。
6.2 数据加工链路
推理数据
推理源被规范化到统一 schema,并按“自包含性、答案证据、推理价值”路由为 accepted / rewrite / pending / holdout / rejected 五类视图。“题目本身有价值但原始轨迹不适合训练”的样本会被抽成独立问题、由教师模型重构或改进,并在通过解析有效性、完整性、模板/来源泄漏风险、重复度、可训练性检查后才准入——从而把“题目价值”与“上游轨迹质量”解耦。
指令数据
收集包含 Tulu 与 FLAN 派生数据的大规模指令语料,转换为预训练兼容的原始上下文(raw context);保留合法的短标签任务,把翻译风险子集路由到模型复核,并将部分单轮样本改写成多轮讨论,以增加对话状态与顺序推理的覆盖——同时仍保持全序列训练目标。
Agentic 数据(MDP 重构)
这是报告最具方法论特色的部分:遵循 agentic continual pre-training 的思路,把通用交互轨迹重构为马尔可夫决策过程(MDP)风格的状态条件式“下一动作预测”样本:
- 状态 s = 任务描述 + 交互历史 + 当前环境反馈;
- 动作 a = 模型在该状态下预测的合适下一步动作;
- 学习目标从“复现完整的状态转移序列”转移到“状态条件下的动作选择”,在整条轨迹信号之外提供更稠密的逐步监督。
对软件工程轨迹,则按是否有真实执行环境采取不同过滤:无执行环境的轨迹用结构、补丁、shell/edit、日志与行为证据筛选(而非自报的运行时结果);有执行环境的轨迹按实际执行结果、最终交互轮反馈、交互轮数联合打分过滤。
6.3 超参与 256K 路线选择
| 项目 | 取值 |
|---|---|
| 训练目标 | 全序列因果语言建模(raw context),区别于 SFT 的仅 assistant 计损 |
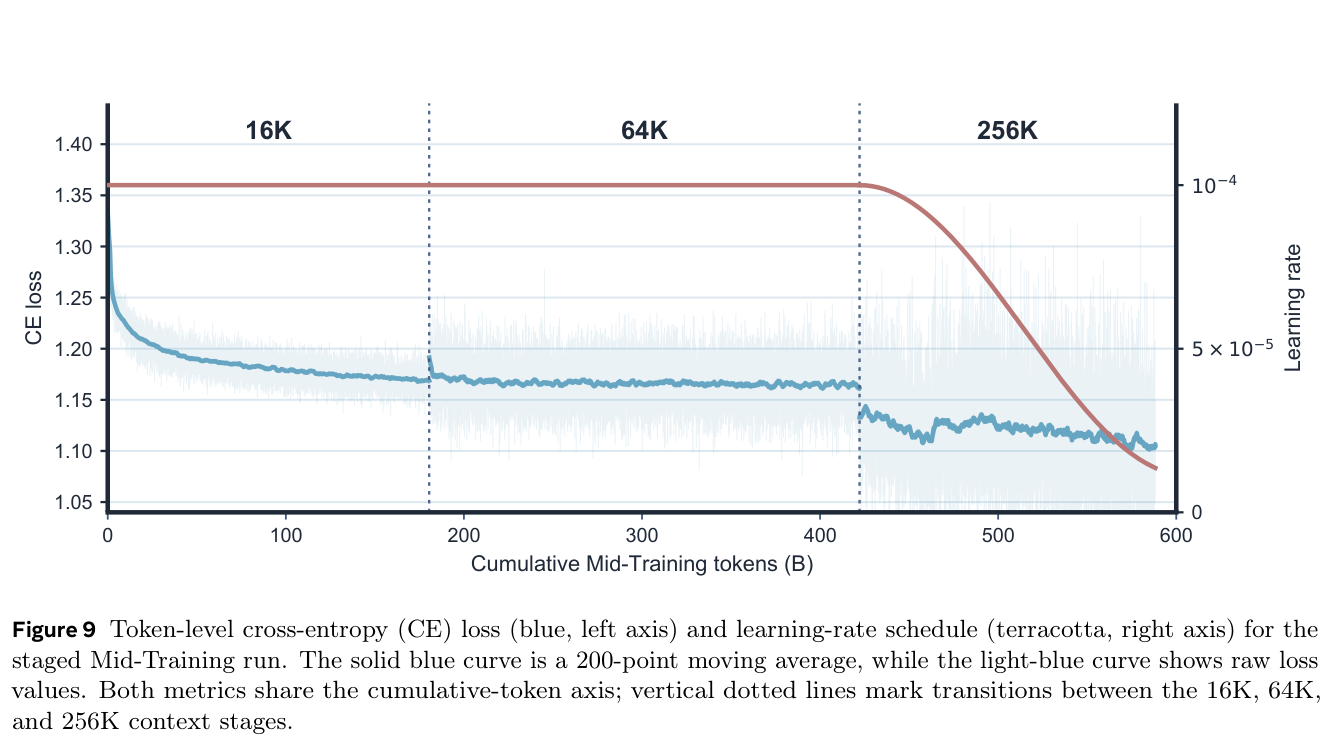
| 每优化步 tokens | 三阶段统一约 12.6M |
| 全局 batch size | 768(16K)/ 192(64K)/ 48(256K) |
| 学习率 | 1×10⁻⁴ |
| 256K 阶段 | RoPE base 10M,完整激活重计算(full activation recomputation) |
| 256K 路线对比 | 直接路线 30B tokens vs 分阶段路线(10B@64K → 20B@256K);分阶段最终 loss 略低(1.16 vs 1.19),吞吐相当 |
6.4 训练期监控(一个可复用的工程细节)
作者在通用预训练与中训练全程持续监控训练动力学、数值稳定性、硬件/系统状态、训练效率与资源利用率。其中记录了一个很有代表性的吞吐衰减排查:
7. 后训练:SFT 与混合 RL
后训练 = SFT(建立响应模式) → 混合 RL(在数学/代码等单域任务上增益)。SFT 语料共 4,921,933 条样本,其中通用数据 96.46%、Agentic 数据 3.54%。
| 组件 | 占比 | 主要作用 |
|---|---|---|
| General data | 96.46% | 指令跟随、知识、数学、科学、代码、对话、推理 |
| Agentic data | 3.54% | 深度研究、软件工程、通过结构化工具进行的终端交互 |
| 合计 | 100.00% | 全部 SFT 数据 |
7.1 数据质量分级与去污染
两段式筛选:确定性启发式规则先行(剔除缺失对话轮、非法角色、重复生成、prompt 模板泄漏、畸形推理轨迹等结构缺陷),再由经人工标注校准的模型评估器按教育价值、逻辑严谨性、逐步推理连贯性、事实一致性、安全合规等多轴打分,将样本离散分级(而非刚性二值阈值):高分优先、临界样本转入辅助验证管线、噪声/高风险样本严格丢弃;拒答样本单独隔离过滤以消除过度拒答。
去污染:全部候选 SFT 语料与所有下游评测/验证集用 8-gram 滑窗比对,任何与评测 prompt 或参考答案 8-gram 重叠 > 50% 的训练样本被永久剔除。
受控对比中,砍掉约一半候选池使六基准均值从 67.78 提升到 68.83;增益集中在推理(BBH +10.10),损失局限于部分任务。因此优先保留可靠、高价值的监督信号,而非最大化样本数。
7.2 长 CoT 的非单调性
在数学、代码生成、多轮对话与复杂指令跟随上做配比消融后发现:过度放大长链式思维(long CoT)轨迹会引入啰嗦偏置(verbosity bias)并损害指令遵循。作者通过迭代式网格校准,调和“长程推理 / 直答 QA / 严格格式指令”三者的比例,最终到达一个平衡的 Pareto 最优混合。
长 CoT 监督的效用是非单调的:在训练混合中过度饱和长推理轨迹会降低通用指令跟随性能。动态校准数据配比可缓解该退化,在保持强指令遵循的同时不牺牲长 CoT 推理增益。
7.3 统一的 think / no-think 监督
SFT 语料刻意把 think 样本(含结构化推理标签包裹的端到端推理链)与 no-think 样本(简洁即时回答)交织。这一双模式设计让同一套权重可以依系统指令或运行时预算,在“完整深思”与“高效零样本直答”之间动态切换。
更重要的是:中间 checkpoint 评测确认联合训练带来正向的跨模态迁移——暴露于结构化推理轨迹,会直接提升 no-think 模式在代码、数学与逻辑推理上的准确率(详见附录 B.4)。
7.4 Agentic 数据:三条支线
关键工程约束:每条任务族的训练 schema 必须与下游推理环境对齐(系统指令、消息角色、工具定义、结构化调用、观测放置、最终答案约定)。实验表明 schema 不匹配会显著损害下游 Agent 性能。
只做 Agent 微调会降低交互保真度,因为 Agent 能力本质上依赖广谱通用能力。与通用指令数据联合训练提供了逐步推理与精确约束遵循的必要基础,带来显著更优的 Agentic 性能。(作者对比了“先通用后 Agentic 的顺序调度”与“全程交织的联合调度”,后者胜出并用于最终训练。)
7.5 训练目标与超参
所有样本渲染为统一的 GLM-5.1 会话格式,采用仅 assistant 计损:assistant 的推理、回答与结构化工具调用计入 loss;system/user 消息与 tool 观测作为被掩码的上下文。该混合 think/no-think 目标同时训练“推理、回答生成、动作选择”,而不教模型复现环境反馈。
| 项目 | 取值 |
|---|---|
| 长度变体 | 最大序列长度 65,536 与 262,144 两种 |
| 轮数 / 数据量 | 64K 变体 8 epochs;256K 变体 10 epochs,含 19.46B packed tokens(发布版) |
| 全局 batch size | 48(两变体一致) |
| 优化器 | 矩阵参数用 layer-wise Muon,标量参数用 Adam |
| 学习率 | cosine 衰减 1×10⁻⁴ → 1×10⁻⁶,无 warmup,weight decay 0.01,梯度裁剪 1.0 |
中训练阶段建立的长上下文基础,使模型仅用中等长度 SFT 数据就能在 256K 规模上可靠地激发推理与 Agentic 行为。这实际上绕过了后训练阶段昂贵的 256K 长推理轨迹——说明短序列监督足以激活并外推在中训练中已建立的长序列能力。
7.6 混合强化学习(Mixed RL)
- RL 数据策展:覆盖数学、代码与通用能力任务;用初始策略做 rollout 估计 prompt 难度,移除模型已能频繁解出的问题,把训练集中在仍能提供有效学习信号的 prompt 上。
- 奖励设计:数学用二值答案正确性奖励;代码用可执行测试通过比例奖励;通用能力用相应正确性/指令跟随判据。无效或截断的回答不获得正奖励。
- GRPO:在最大回答长度 64K 下,结合 outcome-based 奖励 + 参考策略 KL 正则 + 轻度长度惩罚。KL 控制策略漂移,长度惩罚降低超长/截断回答带来的奖励噪声,支持可靠的多步推理而不鼓励无谓的答案膨胀。
- 动态采样:奖励方差为零的 group 不提供有效的相对学习信号,训练中动态过滤并替换。actor 学习率 2×10⁻⁶。
- 采样规模:两种探索——每步 24 题 × 每题 16 回答 = 384 轨迹;或每步 384 题 × 每题 8 回答 = 最多 3,072 轨迹。rollout 允许在总 98,304 tokens 的 prompt+response 上下文内新生成最多 65,536 tokens。
8. 评测结果:7B 对标与 Agentic 能力
评测设置:think 模式,使用发布的 256K SFT checkpoint;非 Agentic 与 web 深度研究均用 temperature 1.0、top-p 1.0;总上下文预算 262,144 tokens(最多 4,096 prompt + 258,048 生成);非 Agentic 基准报告 32 次运行的 mean pass@1。
8.1 7B–8B 量级对比(20 项基准)
| 基准 | ZGCM-1 7B | R1-0528-Qwen3-8B | MiniCPM4.1-8B | Qwen3-8B | Olmo3-7B-Think |
|---|---|---|---|---|---|
| 推理与通用 | |||||
| MATH-500 | 97.13 | 96.32 | 95.60 | 96.20 | 95.10 |
| AIME 2024 | 80.62 | 83.33 | 83.33 | 80.00 | 71.60 |
| AIME 2025 | 73.33 | 75.21 | 73.33 | 63.33 | 64.60 |
| AIME 2026 | 75.00 | 69.17 | 71.67 | 66.67 | 66.16 |
| HMMT 2025 | 70.42 | 61.50 | 52.50 | 43.33 | 43.89 |
| HMMT 2026 | 59.48 | 51.52 | 46.21 | 45.45 | 43.94 |
| AGIEval SAT Math | 99.09 | 91.14 | 98.98 | 99.09 | 90.45 |
| AQuA-RAT | 90.57 | 90.88 | 91.39 | 92.62 | 90.98 |
| HARDMath-mini | 56.34 | 61.92 | 51.89 | 63.31 | 58.90 |
| IMO-AnswerBench | 53.00 | 55.00 | 54.25 | 45.00 | 45.25 |
| MATH-P-Hard | 79.21 | 82.53 | 84.41 | 82.08 | 77.42 |
| OlympiadBench | 76.06 | 74.75 | 82.75 | 82.47 | 69.55 |
| ARC-AGI-1 | 3.50 | 1.69 | 2.58 | 3.00 | 3.25 |
| miniF2F | 2.87 | 5.12 | 0.00 | 2.87 | 3.28 |
| 代码 | |||||
| HumanEval+ | 90.24 | 88.87 | 89.63 | 80.20 | 89.90 |
| MBPP+ | 63.23 | 65.54 | 63.96 | 69.10 | 64.70 |
| LiveCodeBench v6 | 46.86 | 53.57 | 52.14 | 52.20 | 49.26 |
| 知识 | |||||
| MMLU | 73.88 | 82.09 | 83.51 | 85.40 | 77.80 |
| GPQA-Diamond | 47.87 | 60.10 | 47.98 | 59.09 | 49.94 |
| 指令跟随 | |||||
| IFEval | 75.42 | 72.37 | 73.24 | 87.40 | 88.20 |
原表还包含 MiMo-7B-RL 与 Open Thinker3-7B 两列;上表为便于对照列出主要 5 列。粗体/浅蓝标记沿用原文着色规则。
8.2 Web 环境深度研究
| 模型 / 系统 | WebWalkerQA | BrowseComp | GAIA (text-only) |
|---|---|---|---|
| ZGCM-1-7B(本文) | 63.09 | 19.43 | 42.52 |
| 开源研究 Agent | |||
| WebDancer-32B | 38.40 | 2.50 | 40.70 |
| 带工具的开放权重模型 | |||
| Qwen3-235B-A22B | 59.60 | 2.30 | 45.60 |
| Kimi-K2 | 63.00 | 14.10 | 57.30 |
| DeepSeek-R1 | 10.00 | 2.00 | 31.10 |
| QwQ-32B | 4.30 | 0.50 | 22.30 |
| 带工具的闭源模型 | |||
| GPT-4o | 33.80 | 1.90 | 34.60 |
| GPT-5 | – | 54.90 | 76.40 |
| Claude 4 Sonnet | 61.70 | 12.20 | 68.30 |
Web 深度研究使用thinking-enabled ReAct 策略,最多 64 个“搜索-阅读”步骤。值得注意:在 BrowseComp 上 ZGCM-1(19.43%)超过了 Claude 4 Sonnet(12.20%)与 Kimi-K2(14.10%),仅次于 GPT-5。
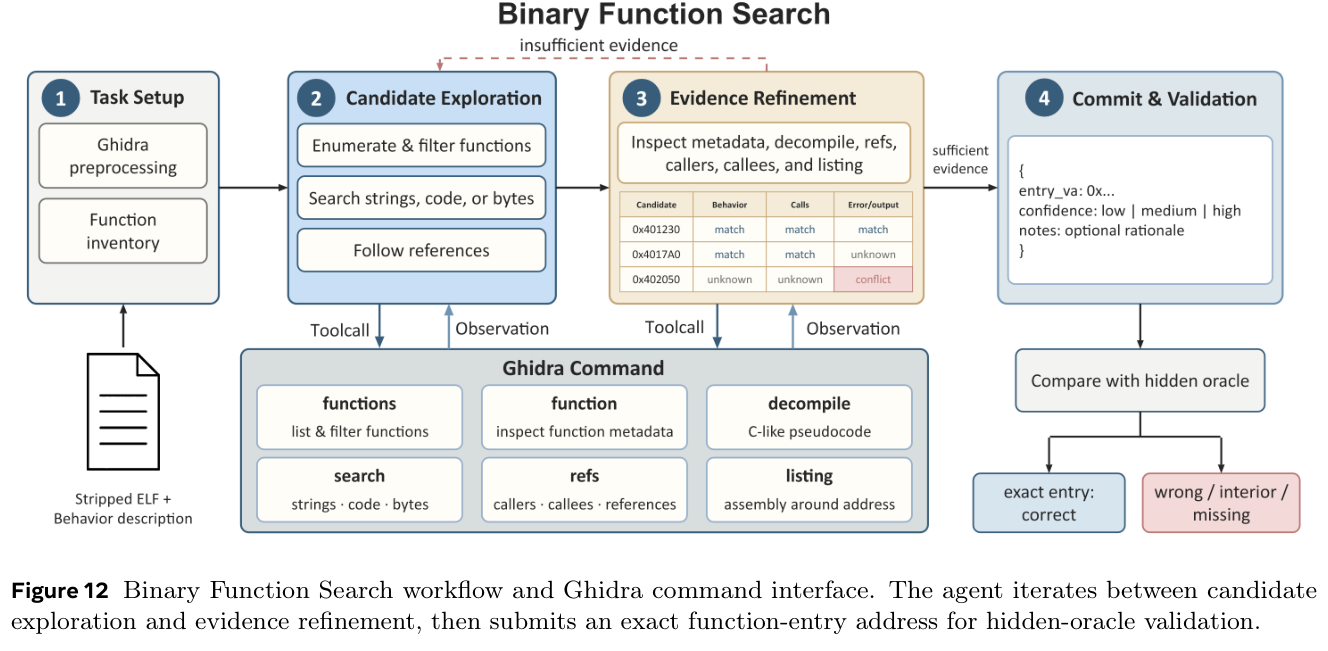
8.3 Binary Function Search(二进制函数定位)
该基准考察 Agent 能否仅凭行为描述,在被 strip 的 ELF 二进制中定位目标函数。数据来自数千个开源 C/C++ 项目构建的“strip / 未 strip”配对;已校验数据池含 529 个项目、11,767 个任务。评测用 50 任务子集(10 个代表项目各随机 5 个,全部为训练集未见的 held-out 项目:tmux、tree、GNU Wget2、XZ Utils、YAJL、zlib、libuv、libgit2、nm、Lua)。
| 模型 / 系统 | 有效提交 | 正确 | 准确率 (%) |
|---|---|---|---|
| 更大规模前沿模型 | |||
| DeepSeek-V4 Flash | 50/50 | 38/50 | 76.00 |
| Qwen3.5-397B-A17B | 50/50 | 38/50 | 76.00 |
| GLM-5.1 | 50/50 | 33/50 | 66.00 |
| ZGCM-1-7B | 50/50 | 31/50 | 62.00 |
| Kimi-K2 | 50/50 | 31/50 | 62.00 |
| DeepSeek-R1 | 46/50 | 18/50 | 36.00 |
| GPT-4o | 50/50 | 9/50 | 18.00 |
| 同量级模型 | |||
| ZGCM-1-7B | 50/50 | 31/50 | 62.00 |
| Qwen3-8B | 50/50 | 6/50 | 12.00 |
评测协议要点:只接受精确匹配函数入口的 ELF 虚拟地址;文件偏移、运行时地址、函数内部指令均判错。判分对照由对应未 strip 二进制构建的 hidden oracle。ZGCM-1-7B 达 62%,远高于同量级基线(Qwen3-8B 12%,其余 0%),逼近 GLM-5.1(66%),并超过 DeepSeek-R1 与 GPT-4o。
8.4 内部诊断:SWE-bench 与 Terminal-Bench(作者主动披露的短板)
作者在附录中如实给出了两个“通用软件/终端 Agent”诊断结果:
- SWE-bench Verified Mini50:最佳完全审计的 ZGCM 家族评测仅解决 2/50(4.0%)。
- Terminal-Bench 2.0:最佳完全审计评测仅解决 2/89(2.25%)。
9. 八条经验性发现(Findings 1–8)
报告的核心可复用产出是八条跨生命周期的可操作经验。前七条散布于各章节,第八条来自 AI-Native R&D 的自主度评估。汇总如下:
词法复杂度是通用语言的廉价排序信号,却是代码/数学的糟糕难度代理(表层统计反映样板而非算法深度)。只对通用语言排序、代码数学独立交织,可改善技术域 BPB,代价是通用域 0.03–0.09 BPB。
抑制中间激活离群值对 FP8 稳定至关重要;delayed scaling + TWEO 正则防发散,同时维持 60% BF16 等效 MFU。
SWA(1.4×) × FP8(1.5×) × Muon(1.8×) × Pre-LN(1.1×) ≈ 4.2× 的 16K time-to-loss 加速。
砍掉约一半候选池,六基准均值 67.78 → 68.83,BBH +10.10;损失局限于部分任务。优先保留可靠高价值监督。
长 CoT 效用非单调:过度饱和会引入啰嗦偏置、损害指令遵循。动态校准配比可缓解退化。
只用 Agent 数据会降低交互保真度;与通用指令数据联合训练提供推理与约束遵循基础,Agent 性能显著更优。
中训练建立的长上下文基础,使中等长度 SFT 即可在 256K 上激发推理与 Agent 行为,省去昂贵的超长推理轨迹。
共享上下文、可复用技能与集成工具让 Agent 能在有限人工干预下迭代,但自主度不均匀:实验监控与部署工程达 L4,而模型架构与学习算法设计停留在 L2、从未超过 L3。
10. AI-Native R&D 与 AI4AI 自主度
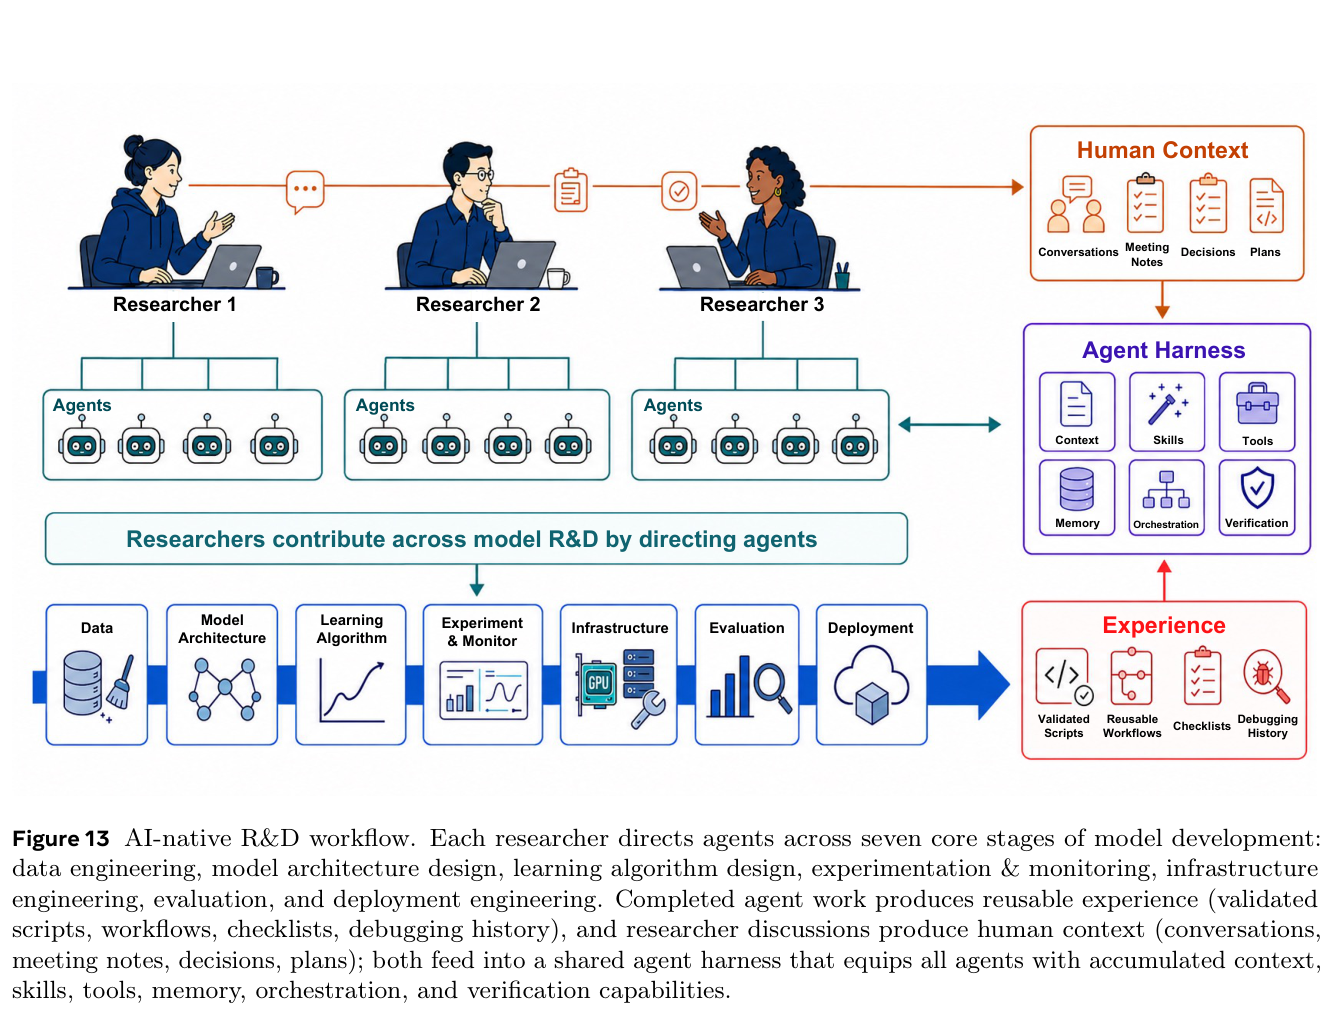
ZGCM-1 的另一条主线是把 AI Agent 深度嵌入模型研发全生命周期。每位研究者指挥若干 LLM Agent,覆盖数据工程、架构设计、学习算法、实验与监控、基础设施、评测、部署七个环节。
10.1 两条信息流:Human Context 与 Experience
- Human Context(人类上下文):研究者讨论产生的对话、会议记录、决策、计划;
- Experience(可复用经验):完成的 Agent 工作产出已验证脚本、可复用工作流、检查清单、调试历史。
两股流汇入共享的 Agent Harness,为每个 Agent 装备 context、skills、tools、memory、orchestration、verification 能力。
10.2 四个落地场景
- 数据清洗:Agent 先写启发式过滤/转换脚本并在目标语料上执行,再检查产出数据的构成与分布统计,判断是否满足质量标准;若不符则自动迭代脚本、细化规则与阈值。
- 集群管理:与 Agent 协作共同开发了完整 skill package(暴露创建开发机、提交训练任务、改资源配置、流式日志、过滤状态字段等结构化接口)。Agent 可独立启动实验、监控进度、从日志诊断失败、调整超参与资源分配,无需人工干预。
- Auto Research:配备文献检索与集群管理工具后,Agent 可探索算法候选与超参配置、启动训练、分析结果并迭代。例如 Agent 对存储集群的数据传输特征做剖析,并针对性调整训练框架的 I/O 管线,完全通过自主 Agent 工作带来显著训练加速。
- 评测(ACE):把评测当作开发工具而非终局评估。见下。
10.3 Atomic Capability Evaluation(ACE)
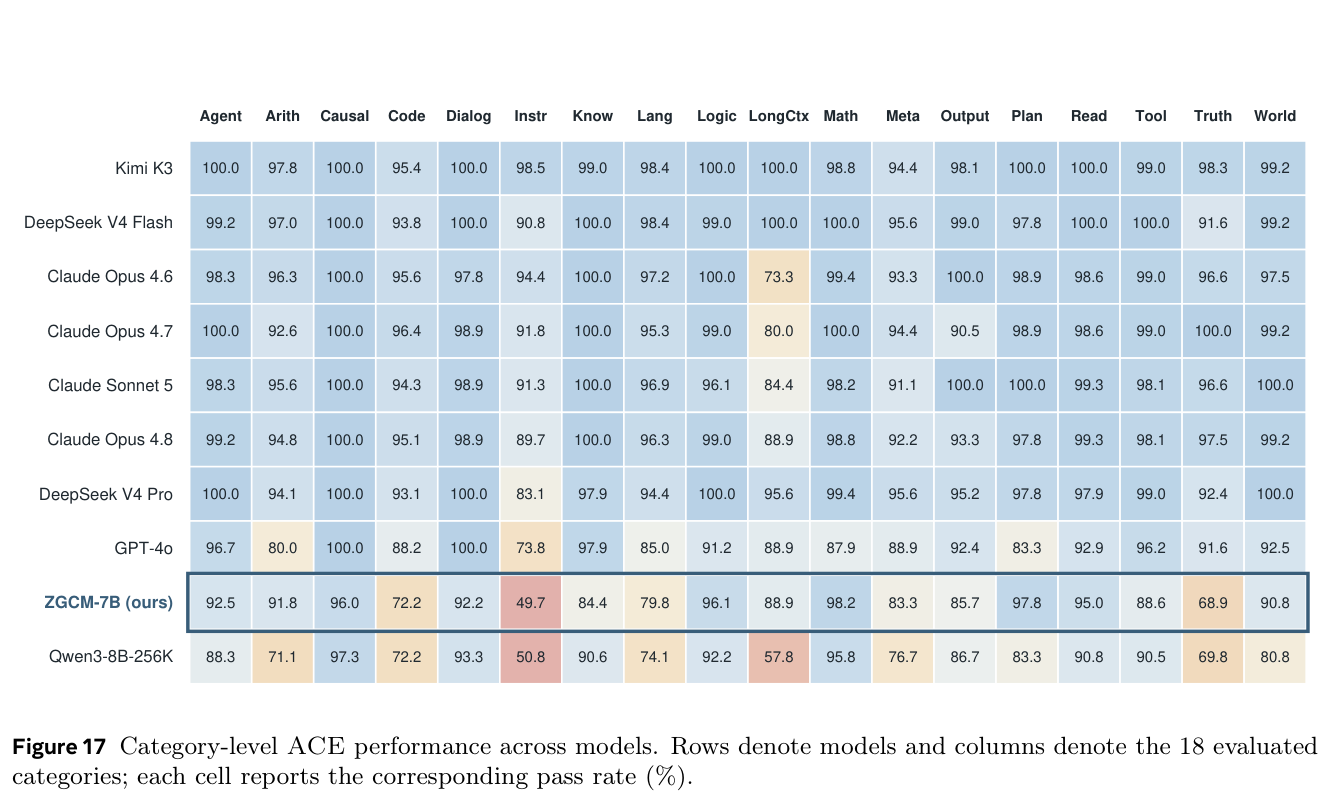
ACE 是一个细粒度诊断基准:18 个类别、183 个原子能力、2,503 个可执行探针(835 L1 / 835 L2 / 833 L3);完整一轮约 2–3 分钟,可快速刻画强弱项。其四条设计原则:
- 原子性:每个能力语义边界狭窄,失败能定位到具体行为而非整个领域。
- 探针多样性:每个能力用多种表层形式、三个难度级测试,降低对单一措辞的敏感性。
- 意图感知评分:仅当格式本身是目标行为时才严格整串匹配;否则抽取实质答案并归一化非语义差异。
- 可追溯性:每个判定都链到探针、参考答案、评分策略、抽取答案与失败记录。
评分路径:2,503 个探针中 2,155(86.1%)用确定性评分(数值/字符串/选择题/AST/单元测试/JSON Schema),其余 348(13.9%) 因正确性无法可靠表达为可执行判据,调用独立模型按预定义二值 rubric 评判。
10.4 AI4AI 自主度评估
AI4AI(AI for AI)指用 AI 系统构建、评估、改进其他 AI 系统。为评估 Agent 能承担多少责任,9 位核心贡献者对 11 个任务类别按五级 rubric 打分,共 99 条评分。
| 级别 | 名称 | 定义判据 |
|---|---|---|
| L1 | Basic Assistance | 人类主导并执行工作流;AI 协助单个步骤。 |
| L2 | Partial Automation | AI 执行预定义工作流;人类指定流程并处理异常。 |
| L3 | Conditional Autonomy | AI 适应并管理常规工作流;重大决策需人类批准。 |
| L4 | High Autonomy | AI 在人类设定的目标与约束内独立规划、执行、迭代。 |
| L5 | Full Autonomy | AI 还能自行确立研究目标并跨 R&D 阶段协调持续改进,无需常规人工指导。 |
L4/L5 的分界是“是否自主形成目标”:L4 在人类定义的目标内独立执行;L5 还能识别研究目标并跨阶段协调工作。
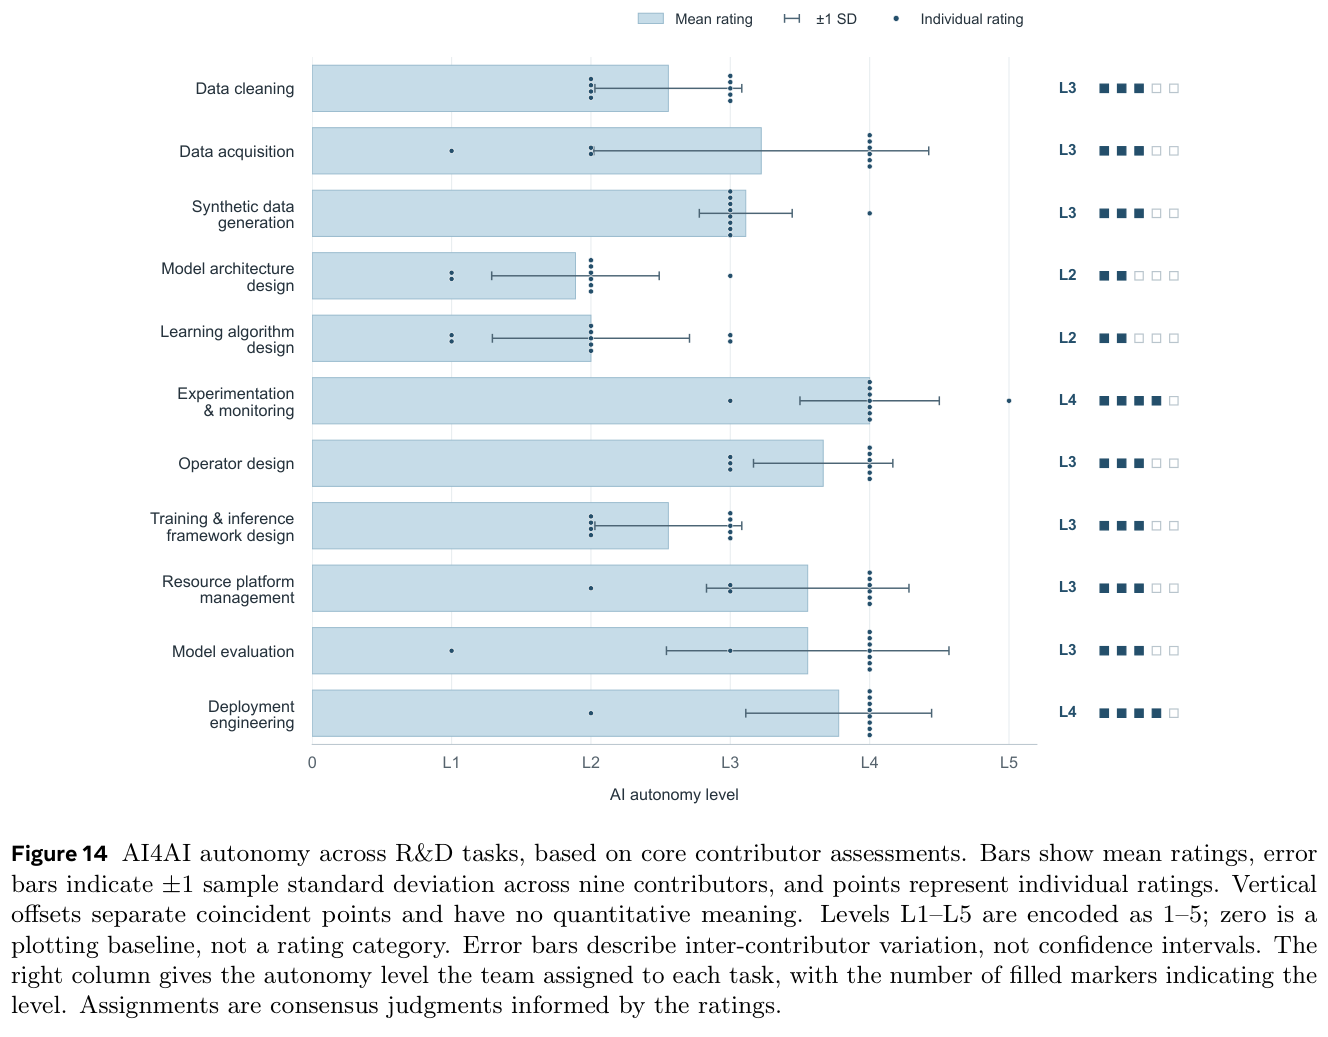
| 任务类别 | 指派级别 | 说明 |
|---|---|---|
| Experimentation & Monitoring | L4 | 自主度最高(99 条评分中唯一一条 L5 也在此项) |
| Deployment Engineering | L4 | 高自主度 |
| Model Architecture Design | L2 | 最低;从未收到高于 L3 的评分 |
| Learning Algorithm Design | L2 | 最低;从未收到高于 L3 的评分 |
| Data Cleaning / Data Acquisition / Synthetic Data Generation | L3 | 数据工程三项 |
| Operator Design | L3 | — |
| Training & Inference Framework Design | L3 | — |
| Resource Platform Management | L3 | — |
| Model Evaluation | L3 | — |
核心结论:运维类任务(实验监控、部署)可达 L4,而设计类任务(模型架构、学习算法)停在 L2。作者强调这些是贡献者判断而非标准化测量,且级别刻画的是自主度而非生产力或产出质量——更高自主度不一定意味着更好结果。
11. 局限与未来方向
11.1 四条明确局限
- 参数知识边界:尽管深思与外部搜索补偿了许多事实缺失,静态记忆容量仍受 7.39B dense 规模根本约束;在无检索支持的纯闭卷、召回密集型任务上,自然落后于大规模前沿系统。
- 指令遵循 vs 推理啰嗦:细粒度 ACE 与数据配比消融显示,重度推理监督会引入啰嗦、并略微损害严格非推理的指令跟随(如 IFEval 与复杂表层约束),若不持续校准就会退化。
- 通用软件与终端 Agent 尚处萌芽:模型在结构化 Agent 环境(web 深度研究、二进制分析)表现优异,但更广泛的仓库级长程工程(SWE-bench Verified)与非结构化 Linux 终端导航(Terminal-Bench 2.0)完成率仍然偏低(分别为 4.0%、2.25%)。
- 环境与协议脆弱性:Agentic 执行高度依赖严格 schema 对齐与稳定的环境反馈;极端观测噪声、工具调用格式偏差、外部搜索 API 延迟仍会破坏多步 rollout。
11.2 四个未来方向
- 扩展到稀疏 MoE 架构:把混合 SWA、Muon、MDP 中训练配方迁移到稀疏 MoE 骨干,在保持低推理 FLOPs 的同时扩大参数容量与领域专精。
- 端到端交互式 Agentic RL:从 token 级 SFT 与 outcome 奖励,走向在真实执行沙箱(终端、web、编译器)内直接进行多轮交互式 RL。
- 自主动态知识检索:进一步统一预训练表示与即时自主检索,使模型在检测到参数不确定性时动态触发检索子程序。
- 自演化 AI4AI 研发生态:把 AI-Native Agent Harness 从集群遥测、数据治理、原子评估,扩展到自主假设形成、自动 kernel 优化与闭环合成环境设计。
12. 附录速查:训练配置与关键消融
12.1 分布式训练配置
| 阶段 | 上下文 | TP/PP/CP/DP | MBS/GBS | 重计算 | LR | RoPE base | 备注 |
|---|---|---|---|---|---|---|---|
| 通用预训练 | 16K | 2/1/1/96 | 1/768 | None | 2×10⁻⁴ | 5M | ≈60% BF16-eq. MFU(≈585 TFLOP/s/GPU) |
| 分阶段(step 1) | 64K | 2/1/4/24 | 1/192 | Selective | 1×10⁻⁴ | 5M | 10B tokens |
| 直接 256K | 256K | 2/2/4/12 | 1/48 | Full | 1×10⁻⁴ | 10M | 30B tokens;203 TFLOP/s/GPU |
| 分阶段(step 2) | 256K | 2/2/4/12 | 1/48 | Full | 1×10⁻⁴ | 10M | 20B tokens;204 TFLOP/s/GPU |
12.2 通用预训练的能力演化(54 个 checkpoint)
直接评测 54 个已保存 base checkpoint(累计 0.04T → 4.19T tokens),不做任何 SFT / 指令微调。下表为四个五点窗口平均。
| 基准 | 能力 | 早期 (0.04–0.07T) | ≈1.0T | ≈2.5T | 最终 (3.67–4.18T) |
|---|---|---|---|---|---|
| MMLU | 知识 | 26.37 | 48.32 | 56.94 | 59.52 |
| OpenBookQA | QA | 24.80 | 60.80 | 72.40 | 78.80 |
| CSQA | QA | 19.02 | 57.70 | 64.26 | 67.87 |
| HumanEval | 代码 | 13.66 | 28.29 | 36.46 | 43.54 |
| GSM8K | 数学 | 11.52 | 38.64 | 57.12 | 59.09 |
| Minerva Math | 数学 | 6.80 | 20.40 | 32.80 | 38.40 |
| GSM-Symbolic | 数学 | 1.20 | 25.60 | 49.20 | 64.00 |
| ARC-Challenge | 推理 | 24.96 | 56.07 | 69.74 | 75.90 |
| HellaSwag | 推理 | 24.56 | 42.75 | 52.69 | 57.15 |
| PIQA | 推理 | 53.80 | 64.78 | 69.78 | 74.89 |
| WinoGrande | 推理 | 50.71 | 65.98 | 66.14 | 68.98 |
关键观察:多数增益在 2.5T 之前完成(MMLU 覆盖其总提升的 92%、ARC 88%、WinoGrande 84%),但代码与更难数学基准在最后 1.7T 仍持续上升(HumanEval +7.08、GSM-Symbolic +14.80)。这种分化式边际收益正是后续引入“能力导向中训练”的动机。
12.3 短 SFT 探针(中训练的能力跃迁)
用同一套精选 SFT 语料快速适配每一里程碑 checkpoint 后再评测(区别于上面的直接 base 评测)。从通用预训练结束到中训练结束:MATH-500 35.83% → 74.12%、HumanEval+ 43.29% → 73.78%、IFEval Strict 29.57% → 72.64%、MMLU 44.17% → 72.63%。作者注明:最终探针用 3 个 SFT epoch、之前用 2 个,因此这是“下游潜力提升”的诊断证据,而非严格匹配的因果消融。
12.4 课程 vs 随机(BPB,越低越好)
| 基准 | Random | Curriculum | 方向 |
|---|---|---|---|
| Coding | 1.99 | 0.81 | 大幅改善 |
| Math | 0.97 | 0.94 | 改善 |
| MMLU | 1.03 | 1.12 | +0.09 |
| ARC | 1.05 | 1.09 | +0.04 |
| HellaSwag | 1.05 | 1.08 | +0.03 |
附录还给出定性例子说明为何词法复杂度不能代理“算法/推理难度”:一个含大量程序结构的 WFC 网格构建程序落在代码 shard 的最低 0.01%,而一个两行 NumPy 文件加载片段落在最高 0.01%;数学侧,需在障碍下构造不相交最短路径的“Manhattan Wiring”落在最低 0.11%,而一句加法结合律陈述落在最高 0.01%。
12.5 SFT 数据过滤消融
| 数据处理 | 样本数 | IFEval | MATH-500 | BBH | MMLU | HumanEval+ | MBPP+ | Mean(6) |
|---|---|---|---|---|---|---|---|---|
| Minimal processing | ≈2.08M | 72.64 | 74.12 | 58.49 | 72.63 | 73.78 | 55.03 | 67.78 |
| Broader filtering | ≈1.833M | 71.20 | 77.63 | 65.08 | 70.60 | 65.00 | 58.36 | 67.98 |
| Quality-focused filtering | ≈1.145M | 71.94 | 75.43 | 68.59 | 71.50 | 67.56 | 57.94 | 68.83 |
严格质量过滤版比最小处理版少 44.9% 样本、比广泛过滤版少 37.5%,但六基准均值反而最高(68.83)。单项任务并非全部同向移动,但总体结论明确:高质量数据比单纯增加数据量更有用。
12.6 think → direct 迁移(no-think 模式)
| 基准 | 混合 SFT 前 | 混合 SFT 后 | 变化 |
|---|---|---|---|
| AIME 2025 | 10.00 | 43.33 | +33.33 |
| AIME 2024 | 6.67 | 33.33 | +26.66 |
| MBPP+ | 55.03 | 75.93 | +20.90 |
| BBH | 58.49 | 69.48 | +10.99 |
| LiveCodeBench v3 | 28.00 | 34.31 | +6.31 |
| IFEval | 72.64 | 78.00 | +5.36 |
| MMLU | 72.63 | 70.03 | −2.60 |
| HumanEval+ | 73.78 | 66.46 | −7.32 |
最大增益出现在数学推理与代码生成(AIME 2025 从 3/30 → 13/30)。作者诚实标注:这是观测性的 checkpoint 对比,两轮可能在总训练 tokens、数据构成、checkpoint 历史与优化调度上都不同,不是受控消融;迁移也是任务相关而非普遍的。
12.7 no-think 模式对外结果
| 基准 | ZGCM-1-7B | Olmo 3 7B Instruct | Qwen3-8B (non-thinking) | Qwen2.5-7B |
|---|---|---|---|---|
| MATH-500 | 89.40 | 87.30 | 82.30 | 71.00 |
| AIME 2024 | 33.33 | 44.30 | 26.20 | 11.30 |
| AIME 2025 | 43.33 | 32.50 | 21.70 | 6.30 |
| BBH | 69.48 | 71.20 | 73.70 | 68.80 |
| HumanEval+ | 66.46 | 77.20 | 79.80 | 74.90 |
| MBPP+ | 75.93 | 60.20 | 64.40 | 62.60 |
| LiveCodeBench v3 | 34.31 | 29.50 | 53.20 | 34.50 |
| MMLU | 70.03 | 69.10 | 80.40 | 77.20 |
| GPQA-Diamond | 42.42 | 40.40 | 44.60 | 35.60 |
| IFEval | 78.00 | 85.60 | 86.30 | 73.40 |
| IFBench | 31.67 | 32.30 | 29.30 | 28.40 |
附录 F 强调可复现性需要把数值结果绑定到四层:模型产物、评测数据、调用契约、评分实现;每条评测记录应保留模型 hash、官方数据集 URL 与不可变 revision、split、prompt wrapper、few-shot、system prompt、chat template、模式控制、答案抽取、指标实现、随机种子、超时、推理引擎与版本、硬件、原始输出位置。
13. 解读与工程启示
- 门控 SWA 5:1 是“不改语义、只改掩码”拿吞吐的稳妥方案(256K 3.94× / KV 6.4×),且全局层规律排布便于容量控制。
- 数据质量 > 数量(Finding 4:砍半候选池反而均值更高),且长 CoT 比例必须反复校准(Finding 5),否则指令遵循退化。
- 通用 Agent 训练离不开通用数据(Finding 6),且必须训练 schema 与推理环境严格对齐,否则 schema 不匹配直接损害下游性能。
14. 引用与资产
| 项目 | 内容 |
|---|---|
| 标题 | ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search |
| 作者 | ZGCM Team(Zhongguancun Academy · Zhongguancun Institute of Artificial Intelligence)。Project Lead: Jiyan He;核心贡献者:Guang Liang, Hao Liu, Haoxiang Guan, Jinbo Sun, Junyi Guo, Wenjun Feng, Yantai Xie, Yifei Shen 等 |
| arXiv | arXiv:2609.13356v1 [cs.AI],2026-09-11,48 页 |
| 代码 | github.com/zgcagi/ZGCM-1 |
| 模型权重 | huggingface.co/zgcagi/ZGCM-1-7B |
| 数据集 | huggingface.co/datasets/zgcagi/ZGCM-1-Data |
| 开放内容 | 预训练 / 中训练 / 后训练各阶段权重与中间 checkpoint、训练代码与配置、分阶段数据与数据配方、W&B 日志、评测 harness |
BibTeX
@misc{zgcm1,
  title  = {ZGCM-1: A Fully Open and Extremely Efficient Foundation Model for Math and Agentic Search},
  author = {ZGCM Team},
  year   = {2026},
  eprint = {2609.13356},
  archivePrefix = {arXiv},
  primaryClass  = {cs.AI},
  url    = {https://arxiv.org/abs/2609.13356}
}
本解读的素材来源与边界
- 正文全部事实来自本地 PDF
2609.13356v1.pdf(48 页,PyMuPDF 全文提取后逐节阅读)。 - 插图为论文原始 Figure 直接裁剪(图 4/6/9/12/13/14/17,200 dpi)或复用仓库内论文原图(图 1/2/3),未做任何自绘或修改;图片文件位于
paper_figures/。 - 标注为“解读/启示”的段落是基于论文事实的分析与工程推论,未经实测,落地前需按项目验证;其余内容均为论文原文信息的转述。
- 正文中 Full/Flash-GQA/SWA 1:1/SWA 3:1 的吞吐数值由 Figure 4a 散点位置近似读取,已在表下明确标注,非原文直给数字。
- 生成时间 2026-09-22;中间产物(全文提取、页面渲染、裁图脚本)位于
_extract/。